Настройки Перевода аудио: распознавание, перевод и озвучка
Что делает каждый пункт настроек Перевода аудио, сколько стоит и когда срабатывает: распознавание, модель перевода, стандартные голоса и клоны.
Обновлено 2 ноября 2026 г.4 мин чтения
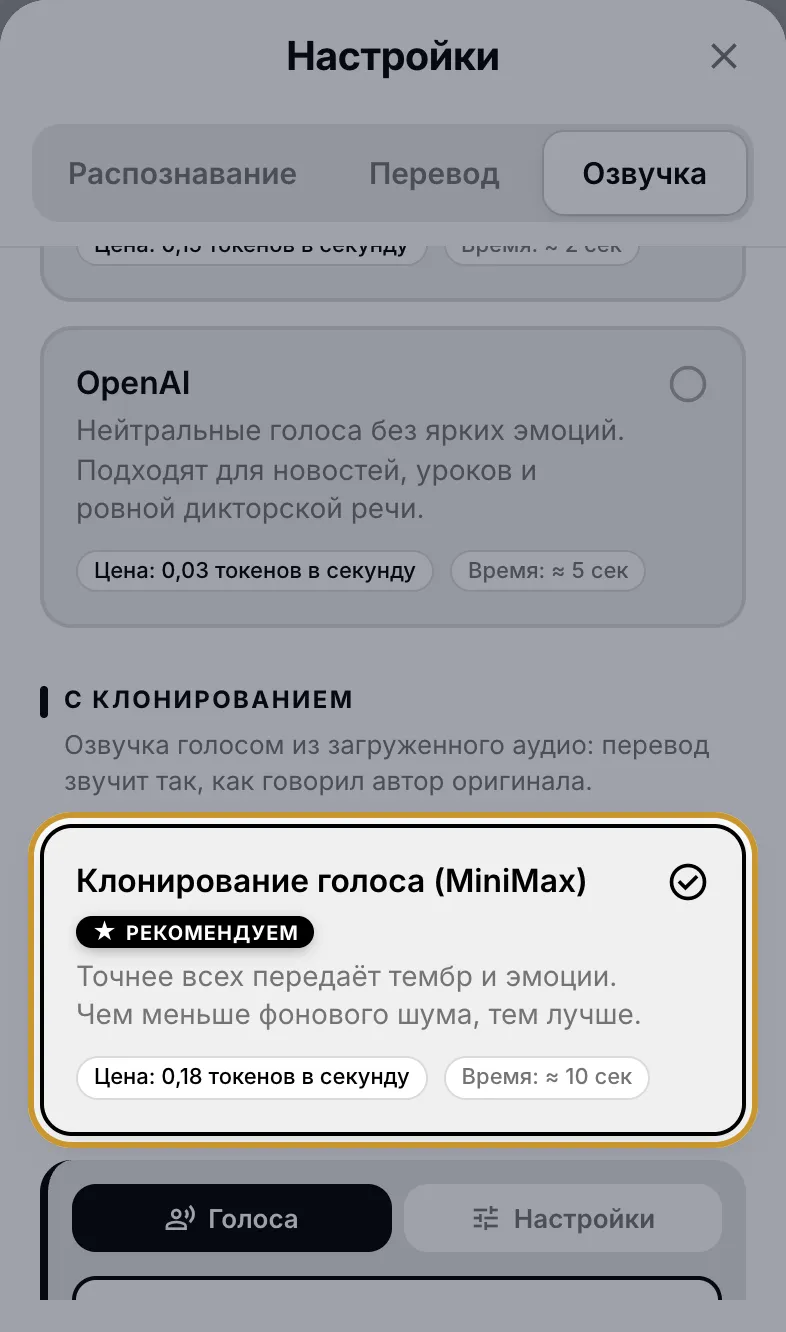
Настройки открываются значком с ползунками в правом верхнем углу Перевода аудио. В шторке три вкладки: Распознавание, Перевод и Озвучка. Выбор сохраняется для следующих записей.
Когда срабатывает изменение
Вкладки срабатывают в разное время, поэтому изменение не всегда меняет результат, который уже на экране.
| Вкладка | На что влияет |
|---|---|
| Распознавание | на следующий выбранный файл |
| Перевод | только на повторный перевод: при смене языка или правке оригинала. Первый перевод нового файла всегда делает Gemini 3.8 Flash |
| Озвучка | на следующее нажатие кнопки воспроизведения |
Распознавание: кто превращает речь в текст
По умолчанию работает ElevenLabs Scribe, он же самый дешёвый. Язык записи всегда определяется автоматически.
| Вариант | Как его описывает приложение | Время | Цена |
|---|---|---|---|
| ElevenLabs Scribe | точно распознаёт речь с акцентом и фоновым шумом, 99 языков | ≈ 3 сек | около 0,7 токена за минуту |
| OpenAI Transcribe | лучше распознаёт термины и имена собственные | ≈ 5 сек | около 1,2 токена за минуту |
| OpenAI Whisper | вариант для длинных записей | ≈ 10 сек | около 1,2 токена за минуту |
Этот же вариант использует инструмент «Аудио в текст»: своих настроек распознавания у него нет.
Перевод: какая модель переводит
Перевод стоит доли токена за 1000 символов, поэтому модель выбирают по качеству и скорости.
| Модель | Когда подходит |
|---|---|
| Gemini 3.8 Flash (по умолчанию) | лучшее качество, справляется со сленгом, идиомами и сложными текстами |
| Gemini Flash Lite | самая быстрая, но в сленге и эмоциональной речи может ошибаться |
| GPT 6 Luna | дешёвая замена для большинства текстов |
Озвучка без клонирования
Стандартные голоса читают перевод быстро и дёшево, но не похожи на говорящего. В Переводе аудио у каждого из них один постоянный голос, сменить его нельзя.
| Вариант | Характер | Время | Цена |
|---|---|---|---|
| ElevenLabs | самая живая интонация из готовых голосов | ≈ 2 сек | 10 токенов за 1000 символов, минимум 1 токен |
| OpenAI | ровный голос без ярких эмоций, для новостей и уроков | ≈ 5 сек | 1,8 токена за каждые начатые 150 слов |
Озвучка с клонированием
Клонирующие варианты озвучивают перевод голосом из вашей записи. MiniMax и Qwen 3 берут голос из первых 60 секунд файла, поэтому в них должна звучать чистая речь одного человека.
| Вариант | Запись от | Языков | Время | Цена |
|---|---|---|---|---|
| MiniMax (с пометкой «рекомендуем») | 10 сек | 38 | ≈ 10 сек | 180 токенов за клонирование и 12 токенов за 1000 символов |
| Qwen 3 | 3 сек | 10: английский, русский, китайский, немецкий, французский, испанский, итальянский, японский, корейский, португальский | ≈ 20 сек | около 20 токенов за 1000 символов, минимум 5; с сохранённым голосом около 11 |
| ElevenLabs Dubbing v2 | без минимума, до 2,5 часа | 94 | ≈ длина аудио | 4,4 токена за секунду записи |
Настройки MiniMax
Клонировать из файла: одноразовый клон для этого перевода. Мой голос MiniMax: один из ваших сохранённых голосов, без 180 токенов за клонирование.
Скорость: от 0.5x до 2.0x. Чем выше, тем быстрее речь.
Эмоция: Авто (рекомендуем), Радость, Грусть, Злость, Страх, Удивление, Спокойствие или Отвращение.
Перевод должен быть не длиннее 10 000 символов.
Если поменять скорость или эмоцию и озвучить тот же результат ещё раз, 180 токенов повторно не списываются.
Настройки Qwen 3
Клонировать из файла или Мой голос Qwen.
Стиль речи: Авто, Медленно, Быстро, Спокойно, Энергично, Профессионально, Дружелюбно или Мягко. Работает только с клонированием из файла.
Если клонирование Qwen не удалось, приложение озвучит перевод стандартным голосом и покажет «Клонирование голоса сейчас недоступно. Использован стандартный голос.»
ElevenLabs Dubbing v2
Dubbing v2 дублирует саму исходную запись и не читает текст с вкладки «Перевод». Он сохраняет темп и тембр голоса и озвучивает каждого говорящего отдельно. Поэтому ваши правки перевода не используются: «Дубляж идёт с исходной записи, отредактированный текст не используется.» Сохранённые голоса с Dubbing v2 не работают.
Что будет, если не выбирать голос
Пока вы не выбрали вариант озвучки в этой шторке, приложение решает само при нажатии кнопки воспроизведения.
Для 10 языков Qwen 3 и записей от 3 секунд голос клонируется через Qwen 3 без вопросов.
Для остальных языков появится «Клонировать голос?» с ценой более дешёвого варианта, MiniMax или Dubbing v2. Голос ИИ означает стандартный голос. С галочкой Больше не спрашивать ответ запоминается.
Вариант, который вы нажали в шторке, сохраняется для следующих файлов, если подходит им по языку и длине.
Вариант, который не подходит текущей записи, показан серым с подсказкой «не поддерживает язык» или «нужно ≥ 10 сек аудио». Если переключиться на язык, которого нет у выбранного варианта, приложение переведёт озвучку на ElevenLabs.
Сохранённые голоса
Сохранённый голос позволяет озвучивать перевод своим голосом, даже если в записи говорит другой человек. Получить его можно двумя способами.
После озвучки с клонированием из файла нажмите Сохранить голос в блоке «Что дальше?». Сохранённый так голос MiniMax в следующий раз не спишет 180 токенов.
Добавьте голос в «Настройки» → «Мои голоса». Как это сделать, описано в статье Как записать или загрузить образец голоса.
Если озвучка звучит не так, признаки и решения собраны в статье Почему озвучка перевода звучит как робот. Ошибки разобраны в статье Озвучка в Переводе аудио не запускается или зависла.
Написать в поддержку
Опишите проблему, и мы ответим на почту. Если есть, укажите имя файла или ID задачи.